AI学習の防止策は、大きく3つに分かれます。学習そのものを妨害する「ノイズ付加」、権利の意思表示と来歴を残す「ウォーターマーク・来歴情報」、そして収集を入口で止める「robots.txtによるクローラー制御」です。どれか1つで完結するものはなく、守る対象と目的に応じて組み合わせます。
イラストや写真を公開しているクリエイター、自社サイトのコンテンツを守りたいWeb担当者、社内文書がAIに読み込まれることを警戒する情報システム部門。立場によって使うべき手段は変わります。しかも、広く紹介されている手法の中には「実際にはAI事業者が準拠していない」ものも混ざっています。
この記事では、ノイズ付加ツールの仕組みと具体的な操作手順、主要AIクローラーの公式な拒否設定、そして企業が社内データを守るための運用設計を、公式情報に基づいて整理します。あわせて、独自取材した先行企業のAI活用事例 から、画像生成の出力管理やAI利用環境の集約に踏み込んだ実例も紹介します。
弊社では、AIの安全な運用に役立つ資料を配布しています。リスク対策や社内ルールの整備などが分かる内容です。情報漏洩や不要な学習を防ぐ、AIを安全に組織に根付かせるノウハウを知れますので、ぜひご覧ください。
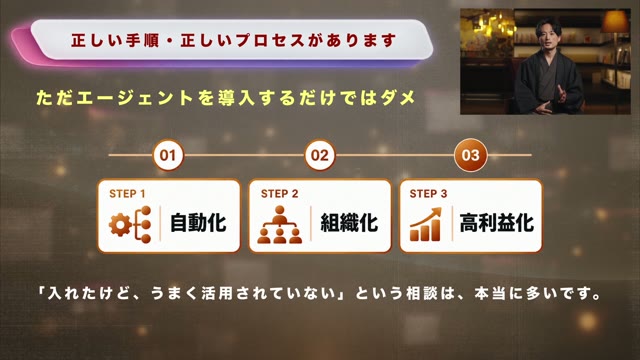
「AI経営」の全3ステップを無料公開
- 【自動化】業務ごとにAI社員をつくる方法
- 【組織化】社長が使えなくても回る「AI専任者」の置き方
- 【高利益化】外注費・ツール費を下げながら売上を伸ばす設計
登録後すぐに視聴できます。※数値は株式会社SHIFT AIの自社実績です。
なぜ「AI学習の防止」が求められるのか
生成AIは公開されたテキストや画像を大量に学習して成り立つため、自分の作品や自社の文書が意図せず学習データに含まれる可能性があります。加えて社内利用では、入力した業務データがモデル改善に使われる契約形態も存在します。この2つが防止策を求める理由です。
防止の必要性は、次の3つの層で発生します。
- 創作物の層: 画風や構図が模倣され、代替物が生成される
- 企業データの層: 社内文書・顧客情報が外部サービス側に残る
- 制度の層: 法規制や利用規約の変化に、社内ルールが追いつかない
生成AIによる無断学習のリスク(著作権・プライバシー)
公開されたイラスト・写真・記事は、クローラーによって収集され学習データセットに含まれることがあります。画風の模倣は、個々の作品をそのまま複製するわけではないため、著作権侵害の成否が争点になりやすい領域です。
問題になるのは次の2点です。
- 画風の学習: 特定の作家名をプロンプトに入れるだけで、その作風に近い画像が生成される
- 個人情報の混入: 顔写真・氏名・所属が含まれた画像やテキストが、そのまま学習対象になる
法的な白黒がつく前に、技術的な自衛策を取る必要が生じている状況です。
企業データが流出するリスク(社内文書・顧客情報)
企業側で発生しやすいのは、社員が個人契約のAIサービスに業務データを貼り付けるパターンです。会社が把握していない利用(いわゆるシャドーAI)が起きると、どのデータがどのサービスに渡ったのか追跡できません。
特に注意すべきは、サービスのプランによってデータの扱いが変わる点です。個人向けプランでは入力内容がモデル改善に利用される可能性があり、法人向けプランでは非学習が契約で保証される、という構造になっているサービスが少なくありません。
法規制・社会的議論の背景(EU AI法・国内動向)
EUではAIに関する包括的な規制が段階的に施行され、学習データの透明性や著作権への配慮が求められる方向に進んでいます。国内でも、生成AIと著作権の関係について文化庁が考え方を整理し、権利者側の意思表示の位置づけが議論されています。
制度が動いている最中である以上、企業に求められるのは「今の規制を満たす」だけでなく、「規制が変わったときに設定を切り替えられる状態にしておく」ことです。
AI学習を防止する代表的な手法
AI学習の防止手法は、①サービス設定によるオプトアウト、②データの匿名化・マスキング、③ウォーターマークによる権利表示の3つが基本です。①は入力データ、②は外部に渡すデータ、③は公開済みの作品を守る手段で、対象が異なります。
守る対象と対応手段の関係を整理すると、次のようになります。
| 守る対象 | 主な手段 | 効き方 |
|---|---|---|
| AIサービスに入力する社内データ | プラン選定・学習オプトアウト設定 | 契約と設定で確実に止まる |
| 外部に渡す文書・データ | 匿名化・マスキング | 渡す前に情報を落とすので確実 |
| 公開済みの画像・記事 | ウォーターマーク・来歴情報 | 抑止と証跡が目的、収集は止まらない |
| 自社サイト全体 | robots.txt によるクローラー制御 | 準拠を公表している事業者には有効 |
利用規約・設定によるオプトアウト(ChatGPTや画像生成AIの設定例)
多くのAIサービスには、入力データを学習に使わせない設定や、そもそも学習しないプランが用意されています。ChatGPTの場合、プランによってデータの扱いが変わります。
| プラン | 月額(税込・目安) | 入力データの学習利用 |
|---|---|---|
| 無料版 | 0円 | 学習に利用される可能性がある |
| Go | 1,400円 | 学習に利用される可能性がある |
| Plus | 3,000円 | 学習に利用される可能性がある |
| Pro | 16,800円〜 | 学習に利用される可能性がある |
| ビジネス(ChatGPTとCodex) | 3,050円(年払・1ユーザー) | 非学習が保証される |
| エンタープライズ | 個別見積 | 非学習が保証される |
※料金・条件は変更されるため、契約前に公式ページで最新の条件を確認してください。
業務利用で押さえるべき点は、個人向けプランでは設定操作が個々の社員に委ねられるという構造です。全社で確実に非学習にするなら、設定の徹底ではなく法人向けプランへの集約が近道になります。
データの匿名化・マスキング
外部サービスに渡す前に、氏名・企業名・金額・製品コードなどを置き換えてしまう手段です。設定や契約に依存せず、渡した先で何が起きても情報が復元されないため、対策としては最も確実です。
実務では、次の順序で処理すると運用に乗ります。
- 分類: 社内文書を「そのまま渡してよい/加工が必要/渡さない」の3段階に分ける
- 置換ルールの固定: 顧客名は「A社」、金額は桁数のみ、といった置換表を作る
- 加工担当の明確化: 誰が加工してから投入するのかを決める
- 抜き取り確認: 月1回、投入ログを抽出して置換漏れを確認する
ウォーターマーク(透かし)による保護
画像に権利表示を重ねる手法です。学習そのものを止める効果は限定的ですが、無断利用時に出所を主張しやすくなり、抑止としても働きます。
方式は2種類あります。
- 可視ウォーターマーク: 画面上で見える形で著作者名やロゴを重ねる。抑止力は高いが鑑賞性を損なう
- 来歴情報(Content Credentials/C2PAなど): 画像に制作者や編集履歴のメタデータを埋め込む。見た目を損なわないが、SNS投稿時にメタデータが除去される場合がある
可視の透かしは、AI学習に対して副作用的な効果を持つ場合もあります。透かし入り画像を学習させると、生成結果にも透かしに似た模様が混ざるという検証報告があり、学習データとしての価値を下げる方向に働きます。ただし透かしを除去する処理も存在するため、単独の対策としては不十分です。
ノイズ付加による防止技術の仕組み
ノイズ付加は、人間の目にはほぼわからない微細なゆがみを画像に加え、AIモデルに誤った特徴を覚えさせる技術です。入口を塞ぐのではなく学習結果を狂わせる「データポイズニング」に分類され、効果は特定の攻撃パターンに限られます。
Glaze・Nightshadeなど代表的ツールの仕組み
Glazeは、シカゴ大学のSAND Labが開発した無料ツールです。公式FAQでは、Windows と Mac(macOS 13.0以上)に対応し、ブラウザ版のWebGlazeは人間のアーティストに限定した招待制で提供されると説明されています。
2つのツールは目的が異なります。
- Glaze(防御型): 自分の作品に加工を施し、その作品から画風を学習されにくくする
- Nightshade(攻撃型): 学習データに取り込まれた際に、モデル側の認識を崩す方向に働かせる
Glazeの公式FAQは、その設計範囲を明確に限定しています。「Glaze was designed to protect artists against art style mimicry, not img2img attacks」と記載されており、既存画像を入力として別画像を生成する使い方(img2img)への防御は想定されていません。
画像・テキストに見えないゆがみを与える原理
AIモデルは画像を「特徴量」という数値の集まりとして把握します。ノイズ付加は、人間の視覚では検知しにくい範囲でこの数値を意図的にずらし、モデルが本来とは違う画風として記憶するように誘導します。
そのため、次のトレードオフが常に発生します。
- 加工の強度を上げる → 学習を狂わせる効果は上がるが、人間の目にも変化が見える
- 加工の強度を下げる → 見た目は保てるが、防御効果は弱まる
Glaze公式FAQも、強度(intensity)を上げるほど視覚的な変化が大きくなると明記しています。強度設定は「どこまでの見た目の変化を許容できるか」で決めることになります。
メリット(学習阻害効果)と限界(ノイズ除去技術の進展)
ノイズ付加の利点は、公開を続けながら自衛できる点です。作品を非公開にしたり解像度を落としたりせずに対策できるため、活動と両立します。
一方で限界も公式に示されています。Glaze公式FAQは、モデル側の進化によってこの性質が無効化される可能性について「Is it possible that AI models evolve significantly to eliminate this property? It’s certainly possible」と述べています。開発者自身が、恒久的な対策ではないと明言している点は正確に押さえるべきです。
限界は次の3点に整理できます。
- 将来のモデルには効かない可能性がある: 開発者自身が可能性を認めている
- 加工前の画像が流通していれば意味がない: 過去公開分は守れない
- 処理コストがかかる: 画像1枚あたりの加工時間は環境に依存し、公式には処理時間の目安が示されていない(実務では数分から数時間の幅で報告されている)
実験データから見る効果の比較(研究・Qiita事例を引用)
効果の検証は研究機関や個人検証で行われていますが、条件によって結果が大きく変わります。比較する際は、次の3条件を揃えて読む必要があります。
| 確認すべき条件 | なぜ重要か |
|---|---|
| 対象モデルとバージョン | 加工が設計された時点のモデルと、検証に使ったモデルが違えば結果は変わる |
| 攻撃の種類 | 画風模倣かimg2imgかで、Glazeの想定範囲内か外かが変わる |
| 加工強度の設定値 | 強度が違えば効果も見た目も変わるため、単純比較できない |
条件が明記されていない「効果があった/なかった」という報告は、自社の判断材料には使えません。導入判断をするなら、自社が実際に使う画像・強度設定で小規模に試し、見た目の許容度と加工時間を実測するのが確実です。
AI学習防止ツールの比較と使い方|Glaze・Nightshadeほか主要ツール
AI学習防止ツールは、①学習を妨害するデータポイズニング型、②権利と来歴を残す表示型、③収集を止めるブロック型の3系統に分かれます。同じ名前で並べて紹介されがちですが、効く場面はまったく別です。
主要ツールの比較表
| ツール/手段 | 系統 | 開発元 | 対象 | 提供形態 |
|---|---|---|---|---|
| Glaze(画風保護の第一候補) | ①学習妨害 | シカゴ大学 SAND Lab | 画像(画風保護) | 無料。Windows/Mac(macOS 13.0以上)。WebGlazeは招待制 |
| Nightshade | ①学習妨害 | シカゴ大学 SAND Lab | 画像(モデル側への影響) | 公式サイトで確認 |
| Mist | ①学習妨害 | 研究プロジェクト | 画像 | 公式サイトで確認 |
| PhotoGuard | ①学習妨害 | 研究プロジェクト | 画像(編集への耐性) | 公式サイトで確認 |
| Content Credentials(C2PA) | ②来歴表示 | C2PA/CAI | 画像・動画・音声 | 対応アプリの機能として提供 |
| 可視ウォーターマーク | ②権利表示 | 各画像編集ソフト | 画像 | 使用中のソフトの標準機能 |
| robots.txt によるクローラー制御(企業サイトの第一候補) | ③収集ブロック | ―(Web標準) | 自社サイト全体 | 自社サーバー設定のみ、費用なし |
※料金・対応OS・提供条件は変更されます。導入前に各公式サイトで確認してください。
判断の目安は次のとおりです。
- 公開作品の画風を守りたい → ①学習妨害型を作品公開前の工程に組み込む
- 無断利用時に出所を主張したい → ②来歴表示型を併用する
- 自社サイト全体の収集を止めたい → ③robots.txt が唯一の実効的手段
なお、AI生成物を「検出する」サービスは学習防止ツールとは別系統です。生成物の判定と学習の防止は目的が逆なので、混同すると選定を誤ります。
【手順】Glazeでノイズを付加する4ステップ
Glazeの操作は次の流れです。加工は不可逆の見た目変化を伴うため、必ず元ファイルを残します。
- 公式サイトからインストーラーを入手する: 対応OSを確認してダウンロードする。初回起動時にモデルデータの取得が走る
- 加工したい画像を読み込む: 複数枚をまとめて処理できる。元画像は別フォルダに退避しておく
- 強度(intensity)とレンダリング品質を決める: 強度を上げると防御効果は上がるが視覚的な変化も増える。まず1枚で試し、拡大表示して許容できるか確認してから全点に適用する
- 出力して公開用ファイルに差し替える: 加工済みファイルのみを公開に使い、未加工ファイルは公開経路から外す
処理時間はマシン性能と画像枚数に依存し、公式には目安が示されていません。大量に処理する場合は、1枚あたりの実測時間を把握してから作業計画を立てます。
CLIP STUDIO PAINT・ibisPaintの標準機能で済ませる
専用ツールを入れずに、使い慣れた画像編集ソフトの標準機能だけで対策する方法もあります。学習を狂わせる効果は専用ツールより弱いものの、工程が既存の書き出し作業の中に収まるため、続けやすいという利点があります。
CLIP STUDIO PAINTでは、画像を統合して書き出す際の設定画面で、ウォーターマークとノイズパターンをまとめて付与できます。
- ウォーターマーク: 著作者名やロゴを重ねる。透明度と配置を調整して鑑賞性との折り合いをつける
- ノイズパターン: 強度を数値で指定する。強度を上げるほど画面のざらつきが目立つため、拡大表示で確認しながら決める
- AI学習禁止の明示: 作品の説明欄に「Not authorized for AI training or machine learning.」のような英文を併記し、意思表示を残す
英文表記は法的な効力を直接持つものではなく、あくまで意思表示です。効果を過大に見積もらず、他の手段と組み合わせる前提で使います。
自社サイトをAI学習から守る設定|robots.txtが実効的、noaiタグは意思表示
自社サイトをAI学習から外す手段として、AI事業者が公式に案内しているのは robots.txt でのクローラー拒否だけです。noai・noimageai といったメタタグは標準規格ではなく、主要AI事業者も準拠を公表していません。
- 実効性があるのは robots.txt でのクローラー拒否のみ(OpenAI・Google・Anthropic が公式に手順を案内)
- noai・noimageai メタタグは標準規格外で、主要AI事業者はいずれも準拠を公表していない
- Google-Extended を拒否しても Google 検索の掲載・順位には影響しない(Google 公式が明記)
主要AIクローラーのrobots.txt記述一覧
各社が公式ドキュメントで公開しているクローラー名は次のとおりです。
| クローラー名 | 事業者 | 役割 | 止めると失うもの |
|---|---|---|---|
| GPTBot | OpenAI | 生成AIモデルの学習用クロール | 学習利用のみ |
| OAI-SearchBot | OpenAI | ChatGPTの検索機能での表示 | ChatGPT検索での露出 |
| OAI-AdsBot | OpenAI | 広告関連の用途 | 該当用途での利用 |
| ChatGPT-User | OpenAI | ユーザー操作に応じたページ取得 | ユーザーからの参照 |
| Google-Extended | Geminiモデルの将来の学習利用の制御 | 学習利用のみ | |
| ClaudeBot | Anthropic | 学習データセット向けクロール | 学習利用のみ |
| Claude-SearchBot | Anthropic | 検索機能での利用 | Claudeの検索での露出 |
| CCBot | Common Crawl | 公開データセット構築 | 各種データセット経由の利用のみ |
OpenAIは公式ドキュメントで、GPTBotの拒否について「Disallowing GPTBot indicates a site’s content should not be used in training generative AI foundation models」と説明しています。Anthropicも同様に、ClaudeBotのアクセスを制限した場合「When a site restricts ClaudeBot access, it signals that the site’s future materials should be excluded from our AI model training datasets.」と公式に記載しています。
学習利用のみを止める場合の記述例は次のようになります。
User-agent: GPTBot
Disallow: /
User-agent: Google-Extended
Disallow: /
User-agent: ClaudeBot
Disallow: /
User-agent: CCBot
Disallow: /*
Google-Extended には注意点があります。Googleの公式ドキュメントは、Google-Extended が単独のHTTPリクエストのユーザーエージェント文字列を持たないこと、そしてこの制御が Google検索での掲載や順位のシグナルには影響しない ことを明記しています。検索流入への影響を心配して設定を見送る必要はありません。
noai・noimageaiメタタグの実際の効き方
<meta name=”robots” content=”noai, noimageai”> のような記述は、2022年11月にDeviantArtが導入した表記が広まったものです。ただし、以下の点を正確に押さえる必要があります。
- 標準規格ではない: W3Cなどの標準に含まれていない
- Googleのrobots metaディレクティブ一覧に含まれていない: 公式にサポートされる指示として扱われていない
- 主要AIクローラーが準拠を公表していない: GPTBot・ClaudeBot などのドキュメントに、このタグに従う旨の記載はない
noai タグを入れても収集は止まりません。効果があるのは、このタグを尊重すると自ら表明しているプラットフォーム内に限られます。「入れておけば拒否できる」という説明を見かけますが、実効的な遮断手段は robots.txt です。
ただし、意思表示としての価値はあります。将来的に規制側が権利者の意思表示を要件化した場合、記録として機能する可能性があるためです。robots.txt を主、メタタグを従として併用するのが妥当な設計になります。
検索流入を落とさずAI学習だけ止める設定
ここが実務上もっとも判断を誤りやすい部分です。AI事業者のクローラーには「学習用」と「検索・回答用」の2種類があり、まとめて止めるとAI検索での引用や露出も消えます。
BtoBサイトの場合、AI検索経由の流入は今後の重要な入口になります。AI経由の集客を残しつつ学習だけ止めるなら、GPTBot・Google-Extended・ClaudeBot・CCBot を拒否し、OAI-SearchBot・ChatGPT-User・Claude-SearchBot は許可します。 目的別の設定は次のとおりです。
| 目的 | 止めるクローラー | 残すクローラー |
|---|---|---|
| 学習だけ止め、AI検索の露出は残す | GPTBot/Google-Extended/ClaudeBot/CCBot | OAI-SearchBot/ChatGPT-User/Claude-SearchBot |
| AI経由の露出も含めて全面的に止める | 上記+OAI-SearchBot/Claude-SearchBot | ― |
| 何もしない(現状のまま) | ― | すべて |
自社サイトが集客を担っているなら、上段の設定が現実的な選択になります。全部を一律で Disallow にする設定は、学習を止める代わりにAI検索からの流入も手放す判断であることを理解した上で決めます。
設定後は、robots.txt が正しく配信されているかを確認し、サーバーログでクローラーのアクセスが実際に減っているかを月次で点検します。
ビジネス現場での実務的な防止策
企業でAI学習を防ぐ実務は、①契約とプランの選定、②社内ドキュメントの取り扱いルール、③利用環境の集約の3点で構成されます。個々の社員に設定を任せる方式は運用が破綻しやすく、会社が用意した環境に利用を集めるほうが確実です。
社内ドキュメントやナレッジをAI学習から守る方法
社内文書を守る手順は、次の4段階で設計します。
- データを3段階に分類する: 「公開可」「加工すれば投入可」「投入禁止」に分け、フォルダ単位で判定できるようにする
- 投入先を限定する: 会社が契約した非学習プランのサービスのみを許可し、それ以外は利用申請を必要とする
- 加工の工程を決める: 顧客名・金額・製品コードの置換ルールを固定し、誰が加工するかを明記する
- 点検の仕組みを作る: 月次で投入ログを抽出し、投入禁止データの混入と置換漏れを確認する
分類を先にやらずにルールだけ配ると、判断が現場ごとにばらつきます。「このフォルダは投入禁止」まで落とし込むのが要点です。
クラウドサービス利用時の契約・規約確認
契約前に確認すべき項目は次の5点です。
| 確認項目 | 見るべき内容 |
|---|---|
| 学習利用の有無 | 入力データがモデル改善に使われるか、契約上どう定められているか |
| データの保存期間と保存場所 | 保存期間、リージョン、削除要求への対応 |
| 再委託先の扱い | 下位のAI提供事業者にデータが渡るか |
| 管理者による設定制御 | 個々のユーザーではなく管理者側で学習設定を固定できるか |
| ログの取得範囲 | 誰が何を投入したかを後から追跡できるか |
この5点のうち、運用の成否を分けるのは「管理者による設定制御」です。個人設定に依存する仕組みでは、社員が設定を変えれば穴が開きます。管理者側で固定できるかどうかで、運用コストが大きく変わります。
クリエイティブ企業での事例(ノイズ付加+権利保護)
制作物を扱う企業では、防止策を制作フローの中に組み込む形が定着しやすくなっています。共通するのは、担当者の判断に任せず、書き出し工程に自動的に処理を挟む設計です。
- 入口の管理: 生成AIに投入してよい素材を、権利関係が確認済みのものに限定する
- 出口の管理: 公開用ファイルの書き出し時に、ウォーターマークやノイズ付加を必ず通す
- 記録の管理: どの素材から何を生成したかを残し、権利上の問い合わせに答えられる状態にする
出口の管理を自動化しておくと、繁忙期に工程が飛ばされる事故を防げます。次のセクションで、この考え方を実装している企業の取り組みを紹介します。
リスクとコストを踏まえた選定基準(どの技術をいつ使うか)
守る対象別に、最初に着手すべき手段を整理すると次のようになります。
| 守る対象 | 最初に着手する手段 | コスト |
|---|---|---|
| 自社サイトのコンテンツ | robots.txt でのクローラー制御 | 設定作業のみ |
| 社内文書・顧客データ | 非学習プランへの集約+分類ルール | 契約費用+運用工数 |
| 公開する画像・イラスト | 書き出し工程でのウォーターマーク付与 | 既存ソフトの機能で対応可 |
| 画風の模倣への対抗 | ノイズ付加ツールの導入 | 無料ツールあり+加工時間 |
費用対効果でみると、着手順は「robots.txt → 非学習プランへの集約 → 書き出し工程の自動化 → ノイズ付加」になります。robots.txt は費用がかからず効果が明確なため、最初に手をつける対象です。
他社の取り組み|バンダイ・花王に学ぶAI学習防止の実装
AI学習防止を運用に乗せている企業は、個々の社員に判断を任せず、仕組みの側で守っています。生成物への権利表示を自動付与する設計と、利用環境そのものを自社管理下に集約する設計の2つが、実装として機能しているアプローチです。
株式会社バンダイ、株式会社BANDAI SPIRITS|画像生成の出力に「Do Not Copy」を自動付与
バンダイとBANDAI SPIRITSは、楽しい企画を考える時間が足りないという課題に直面し、生成AIの活用に踏み込みました。トイホビーデータ利活用プロジェクト(RIPRO)を立ち上げ、社内チャットボットを通じて複数のAIモデルを安全に使える環境を整えています。
権利保護の面で特徴的なのは、画像生成AIの出力に「Do Not Copy」のウォーターマークを自動付与し、著作権侵害を防ぐ仕組みを組み込んでいる点です。担当者が付け忘れる余地をなくし、システム側で必ず処理が入る設計になっています。
同社は「定型業務はAIに任せ、人が『お客様が喜ぶこと』に集中できる環境をつくりたかった」と語っています。防止策を人の注意力に依存させず、横断チームの草の根運動として全社に広げた進め方が参考になります。
詳細は株式会社バンダイ、株式会社BANDAI SPIRITSのインタビュー記事で確認できます。
花王株式会社|ChatGPT無料版を原則禁止し、自社環境に利用を集約
花王は、人が創造性と共感性に力を注げる環境をつくるために生成AIの活用を進めています。学習防止の観点で明確なのは、ChatGPTの無料版を原則禁止し、自社環境での利用に集約している点です。
同社はAzure OpenAI Serviceをベースにした「Kao AI Chat」を整備し、毎日2,000人以上が利用する状態をつくっています。あわせて「Kao AI Academy」で1万人以上が受講する教育体制を敷き、使ってよい環境と使い方の両方を同時に配っています。
同社は「定型業務をどこまで自動化できるかということに注力していきたいです」と語っています。禁止だけを通達すると現場は業務が回らず抜け道を探しますが、代替環境と教育を同時に用意すれば、禁止が機能します。
詳細は花王株式会社のインタビュー記事で確認できます。
2社に共通する設計思想
規模も業種も違う2社ですが、防止策の組み立て方には共通点があります。
- 人の注意力に依存させない: ウォーターマークの自動付与のように、システム側で処理を確定させる
- 禁止と代替を同時に出す: 使わせない環境を示すだけでなく、使ってよい環境を先に用意する
- 教育を同時に走らせる: ルールの背景を理解させ、判断が必要な場面で正しく動ける状態にする
この3点が揃っていない場合、ルールは形式的に残るだけで、実際の投入行動は変わりません。
AI学習防止を成功させるために必要な体制
AI学習防止が機能する企業は、技術・教育・ルールの3つを同時に整えています。ツールを入れるだけでは加工工程が飛ばされ、ルールだけを配ると現場が抜け道を探します。3つのうち欠けているものを特定し、そこから着手するのが最短経路です。
運用フローの設計(誰が加工するのか、どの段階で適用するのか)
設計時に決めるべき項目は4つです。
- 適用タイミング: 公開用ファイルの書き出し時に必ず通す。制作途中ではなく出口に置く
- 担当者: 制作者本人か、公開担当か。兼務にすると繁忙期に飛ばされる
- 例外の扱い: 加工しないケースを認めるか、認める場合は誰が承認するか
- 確認方法: 公開後に加工済みかを抜き取りで確認する頻度と担当
工程を「出口に一箇所だけ置く」ことが要点です。複数の段階に分散させると、どこで漏れたかを追跡できなくなります。
社員教育・リテラシー強化の重要性
教育で扱うべき内容は、ツールの操作方法よりも判断基準です。現場が迷うのは操作ではなく「この資料は投入していいのか」という判断だからです。
教育に含める内容は次の3点です。
- なぜ制限するのか: 学習利用の仕組みと、流出した場合に何が起きるかを具体例で示す
- どこまでが許容範囲か: 投入可・加工必要・投入禁止の3段階を、自社の実データで示す
- 迷ったときの行動: 判断できない場合の相談先と、相談してから投入するという原則
花王が1万人以上の受講規模で教育体制を組んでいるように、対象を情報システム部門に限定せず、投入する当事者である現場全体に届けます。研修の対象範囲が投入者の範囲より狭いと、教育を受けていない社員が判断する構造が残ります。
成功企業の共通点は「技術+教育+ルール」の三本柱
3つの要素は、どれか1つが欠けると全体が機能しなくなる関係にあります。
| 欠けている要素 | 起きること | 打ち手 |
|---|---|---|
| 技術 | ルールを守る意思はあるが、手作業のため漏れる | 書き出し工程への自動処理の組み込み |
| 教育 | ルールの意図が伝わらず、形式的な運用になる | 判断基準を自社データで示す研修 |
| ルール | 個人の判断でばらつき、追跡できない | 分類・投入先・承認フローの明文化 |
自社に欠けている要素を特定するには、「投入禁止データが実際に投入されていないか」をログで確認するのが早い方法です。ログが取れていない場合、まずルールと環境の整備から着手します。
社長の仕事を、どこからAIに任せるか。
自動化・組織化・高利益化。AIエージェントに仕事を任せる「AI経営」の3ステップを、SHIFT AIの実例で解説します。
今後の動向と課題
AI学習防止をめぐる技術と制度は、どちらも流動的です。ノイズ付加は開発者自身が将来のモデルへの有効性を保証せず、robots.txt の対象クローラーも各社の発表で増減します。恒久的な正解を探さず、設定の見直し頻度を決めます。
ノイズ除去技術との“いたちごっこ”
Glazeの公式FAQは、モデル側の進化によって防御効果が失われる可能性を明示的に認めています。防御と突破が交互に進む構造上、一度加工して公開すれば終わりという性質のものではありません。
対応としては、次の2点を前提に置きます。
- 過去公開分は守れない: 加工前に公開した作品は対策の対象外になる
- 再加工が必要になる可能性がある: ツールの更新情報を追い、必要に応じて公開ファイルを差し替える
法的整備・オプトアウト権の進展
権利者の意思表示をどう扱うかは、各国で議論が続いています。現状は robots.txt が事実上の意思表示手段になっていますが、将来的にメタタグや別の仕組みが要件化される可能性もあります。
企業側の備えとして有効なのは、意思表示を1箇所に集約せず、robots.txt とページ側の表記を併記しておくことです。制度が変わったときに、どちらかが有効な記録として機能します。
企業が今後備えるべき対応(コンプライアンス・教育)
制度と技術の変化に追随するために、点検のタイミングを固定します。
| 点検項目 | 頻度 | 担当 |
|---|---|---|
| robots.txt の対象クローラーの見直し | 四半期ごと | Web運用担当 |
| 契約サービスのデータ取り扱い条項の確認 | 年1回+規約改定通知時 | 情報システム部門 |
| 投入ログの点検(禁止データの混入確認) | 月1回 | 情報システム部門 |
| 社員教育の内容更新 | 年1回 | 人事・情報システム部門 |
頻度を決めずに「変化があれば対応する」とすると、規約改定の通知が埋もれて対応が遅れます。カレンダーに入れて、担当者を明記するところまで決めてしまうのが確実です。
まとめ|AI学習防止は「技術+教育+ルール」で進める
AI学習の防止は単一の手段では完結しません。自社サイトはrobots.txt、社内データは非学習プランへの集約、公開作品はウォーターマークとノイズ付加。守る対象ごとに実効性のある手段を選び分けます。
この記事の要点を整理します。
- 自社サイトを守るなら robots.txt: GPTBot・Google-Extended・ClaudeBot・CCBot の拒否は、各社が公式に案内している唯一の実効的手段
- noai・noimageai は意思表示: 標準規格ではなく、主要AIクローラーは準拠を公表していない。収集は止まらない
- 学習だけ止めて検索露出は残せる: OAI-SearchBot や Claude-SearchBot を残す設定が、集客サイトでは現実的
- Google-Extended は検索順位に影響しない: Google公式が明記しているため、流入への懸念で設定を見送る必要はない
- ノイズ付加は範囲限定の対策: Glaze公式FAQが画風模倣向けと明記し、将来のモデルに対する有効性も保証していない
- 社内データは環境の集約で守る: 個人設定に依存させず、非学習プランに利用を集める
- 機能させるには3要素が必要: 技術で自動化し、教育で判断基準を配り、ルールで追跡可能にする
最初の一歩として費用対効果が高いのは、robots.txt の設定です。費用がかからず、効果が公式に説明されており、検索流入への影響も明確になっています。そのうえで、社内データの投入先を非学習プランに集約し、教育で判断基準を配る順序で進めれば、抜け道の少ない体制になります。
ここまでの技術・ルールの整備が終わったら、次の論点は「誰がどこまで判断できるか」です。禁止事項を配るだけでは、判断が現場で止まります。自社の利用ルールと社員教育をどの順序で設計するかは、他社が実際にどこまで踏み込んだかを見るのが最短です。
以下の資料では、リスク対策や社内ルールの整備などを詳しく解説しています。情報漏洩や不要な学習を防ぐ、AIを安全に組織に根付かせるノウハウを知れますので、ぜひご覧ください。
社長の稼働は、週5から週1へ。
自動化・組織化・高利益化。AIエージェントに仕事を任せる「AI経営」の進め方を、SHIFT AIの実例で公開しています。
無料/登録後すぐ視聴
講義を無料で視聴する →よくある質問
- Qノイズ付加は本当にAI学習を防げますか?
- A
特定の条件下では効果が確認されていますが、恒久的な防止策ではありません。Glazeの公式FAQは、画風の模倣に対する保護として設計されたものであり、既存画像を入力とする生成(img2img)への防御は想定していないと明記しています。またモデル側の進化によって効果が失われる可能性についても、公式に「certainly possible」と述べられています。単独ではなく、ウォーターマークやrobots.txtと組み合わせて使う対策です。
- Qノイズを入れると作品の見栄えは悪くなりますか?
- A
加工の強度に比例して視覚的な変化が出ます。Glaze公式FAQも、強度を上げるほど画像に見える変化が大きくなると明記しています。実務では、まず1枚だけ加工して拡大表示で確認し、許容できる強度を決めてから全点に適用します。CLIP STUDIO PAINTのノイズパターン機能のように強度を数値で指定できる場合も、同じ手順で確認するのが確実です。
- Q社内文書をAIに学習されないようにするにはどうすればよいですか?
- A
法人向けの非学習プランに利用を集約するのが確実です。ChatGPTの場合、無料版・Go・Plusは入力データが学習に利用される可能性があり、ビジネス以上のプランでは非学習が保証されます。あわせて、社内データを「投入可・加工必要・投入禁止」の3段階に分類し、フォルダ単位で判定できる状態にします。個々の社員の設定操作に依存させると、設定漏れで穴が開きます。
- Qウォーターマークとノイズ付加はどちらが有効ですか?
- A
目的が異なるため、優劣ではなく併用で判断します。ウォーターマークは無断利用時に出所を主張するための証跡と抑止が目的で、収集そのものは止まりません。ノイズ付加は学習結果を狂わせることが目的で、見た目への影響とトレードオフになります。公開作品を守るなら、書き出し工程でウォーターマークを自動付与し、画風の模倣を警戒する作品にノイズ付加を追加する順序が実務的です。
- Qnoaiメタタグを入れればAI学習を拒否できますか?
- A
拒否できません。noai・noimageai は2022年11月にDeviantArtが導入した表記が広まったもので、標準規格ではなく、Googleのrobots metaディレクティブ一覧にも含まれていません。GPTBotやClaudeBotなど主要AIクローラーも、このタグに従う旨を公表していません。実効的にクロールを止められるのは robots.txt での指定です。ただし意思表示の記録としては意味があるため、robots.txtと併記する形で使います。
- Qrobots.txtでAIクローラーを止めると検索順位は下がりますか?
- A
Google-Extended については下がりません。Googleの公式ドキュメントは、この制御がGoogle検索での掲載や順位のシグナルには影響しないと明記しています。一方で、OAI-SearchBot や Claude-SearchBot は学習用ではなくAIサービスの検索・回答機能で使われるクローラーです。これらを止めるとAI検索での引用や露出が失われるため、集客を担うサイトでは学習用クローラーのみを止める設定が現実的です。